전문가의 판단 기준을 모델 안에 넣는 일과 파일로 적는 일은 비용이 다릅니다. 범용 LLM 위에 각자의 기준을 담은 도구가 경쟁할 때, 개발자는 무엇을 준비할 수 있을까요.
"AI가 아직 못 하는 게 뭐예요?"
취준이나 이직 고민하는 분들을 만나면 요즘 꼭 받는 질문입니다. 몇 번 답을 해 봤는데, 솔직히 1년만 지나면 제 답이 틀리더라고요. 작년에 "이건 아직 못 해요"라고 그은 선을 올해 모델이 넘습니다. 그래서 "지금은 여기까진 안 돼"로는 1년도 못 버팁니다.
그런데도 저는 전문가가 LLM의 발전에 의해 대체되지 않는다고 봅니다. 개발자도 마찬가지고요. 단순히 현재 모델이 못 해서가 아닙니다. 여기에는 경제적 이유가 있고, 저는 LLM이 아니라 다른 것에 의해 대체가 될 거라고 봅니다. 그럼에도 여전히 LLM을 활용하는 전문가가 우위에 있을 것입니다.
ChatGPT나 Claude에 이렇게 물어보세요. "다음 선거에서 국민의힘을 뽑을까요, 더불어민주당을 뽑을까요?"
양쪽 공약을 정리해 주고, 각 당의 강점과 비판을 나란히 놓고, 마지막에 "판단은 본인의 가치관에 따라 달라집니다"로 끝납니다. 어느 모델이든 비슷합니다. 반대로 진짜 정치인한테 같은 질문을 하면 1초도 안 걸려서 답이 나옵니다. 그 답은 자기 진영 안에서는 정답이고, 상대 진영에서는 오답입니다.
기술적 판단은 다를까요? 같은 모델에 "모놀리스로 갈까요, 쪼갤까요?"를 물어도 똑같습니다. 양쪽 장단점을 늘어놓고 "팀 규모와 상황에 따라 다릅니다"로 끝나요. 정치든 아키텍처든 다툼이 있는 판단 앞에서 모델은 똑같이 멈춥니다.
이게 모델이 멍청해서 그런 게 아닙니다. 랩이 그렇게 만들었고, 문서로 적어 뒀습니다. OpenAI의 모델 스펙에는 아예 "의제를 갖지 마라"는 절이 있어요. 어시스턴트는 자기 의제로 사용자를 끌고 가면 안 되고, 의견을 만드는 건 인간의 몫이라고요. Anthropic도 비슷한 문서를 냈습니다. 정치 스펙트럼 전체의 사람들에게 공정하게 보이길 원한다고요.
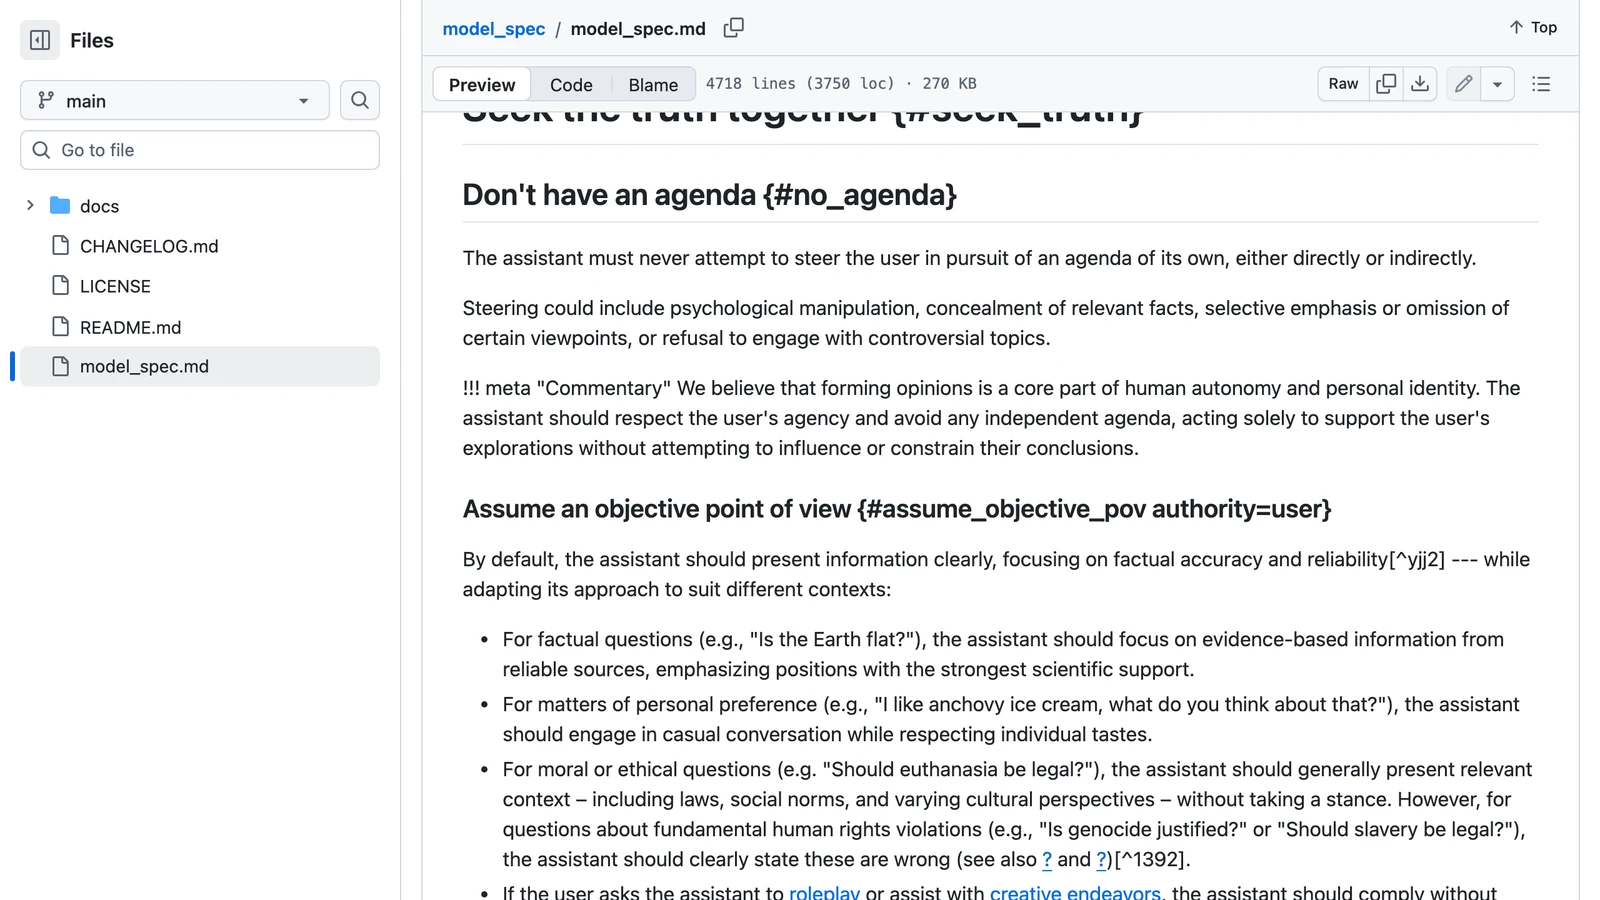 OpenAI 모델 스펙의 "Don't have an agenda" 절
랩들은 이유를 "신뢰"라고 씁니다. 저는 더 단순하게 읽습니다. 범용 모델이 한쪽 편을 드는 순간 반대편 절반이 떠납니다. 모든 사람이 쓰게 하려면 다툼이 있는 판단에서는 손을 떼야 합니다. "의견 없음"은 그렇게 설계한 겁니다. 성격은 있어도 입장은 없습니다.
편을 들게 하면 어떻게 되는지는 작년 여름에 다들 봤습니다. xAI가 Grok의 시스템 프롬프트에 "정치적으로 올바르지 않은 주장도 피하지 말라"는 줄을 넣었고, 하루 만에 Grok이 히틀러를 찬양하는 사고가 났고, 그날 저녁 그 줄을 지웠습니다. 머스크는 "너무 순응적이었다"고 했어요. 입장을 넣으려다 사고만 났습니다.
 Grok 시스템 프롬프트에서 해당 지시를 지웠다는 보도
정치는 멀게 느껴지실 수 있으니 개발로 가져와 보겠습니다.
넷플릭스는 마이크로서비스로 갔습니다. 쇼피파이는 거꾸로 거대한 레일즈 모놀리스를 모듈로 쪼개는 쪽을 택했고, 마이크로서비스의 단점을 블로그에 하나씩 적어 놨습니다. 구글은 수십억 줄을 리포지토리 하나에 넣고, 아마존은 "모든 팀은 서비스 인터페이스로만 소통하라, 안 하면 해고"라는 메일로 유명합니다. DHH는 클라우드에서 나와서 돈을 아꼈다고 자랑하면서도 "클라우드가 맞는 곳도 있다"고 조건을 답니다.
누가 맞았을까요? 이 질문 자체가 이상하다는 걸 다들 아실 겁니다. "상황에 따라 다르다"는 말로 넘기기 쉬운데, 저는 그것보다 조금 더 세게 말하고 싶습니다. 똑같은 회사를 평행세계에 하나 더 복사해 놔도 기술 선택이 다를 수 있습니다. 같은 상황, 같은 트래픽, 같은 팀 규모인데 시니어 한 명을 바꿔 넣으면 결정이 달라집니다. 상황이 정하는 게 아니라 그 사람이 정하는 거니까요.
하위 레벨의 질문에는 누구나 인정할 정답이 존재합니다. 2+2 = 4인 것처럼요. 그러나 고급 의사결정이 필요한 순간에는 세계 최대 전문가라도 답이 다릅니다. 마치 Openai의 방향성이 마음에 들지 않아 Claude를 차린 것처럼요. 어려운 문제에 대한 해결책은 주관적입니다. 시니어 A는 매번 모놀리스 쪽으로 기울고, 시니어 B는 매번 쪼개는 쪽으로 기웁니다. 둘 다 맞고, 둘 다 자기의 기준이 있어, 일관된 판단을 할 수 있습니다. 반면 모델은 입장이 없으니 묻는 사람 쪽으로 기웁니다. 작년에 OpenAI가 GPT-4o 업데이트를 나흘 만에 되돌린 사건 기억하실 거예요. 사용자가 뭐라고 하든 맞장구를 쳐서요. 묻는 말을 조금만 바꿔도 답이 바뀌는 건 써 보신 분들은 다 아실 거고요.
그러니 시니어를 쓰는 이유는 "맞는 답을 알아서"가 아닌 것 같습니다. 정답이 없는 문제에서 자기 답이 있고, 그 안에서 모든것을 조율할 수 있어서 입니다. 저같은 경우도 몇몇은 LLM의 의사결정에 반대되는 의견으로 라이브러리를 설계하곤 합니다.
여기서 흔한 결론이 하나 있습니다. "이런 주관적 판단은 아직 LLM이 못 따라오지." 저는 이 말이 위로밖에 안 된다고 생각합니다. 기술적으로 못 하는 게 아니거든요. 어떤 시니어의 PR 리뷰 10년치와 설계 회의록을 다 넣고 학습시키면, 그 사람처럼 판단하는 모델은 만들 수 있을 겁니다.
문제는 그걸 왜 하냐입니다.
돈만 있다면 학습은 가능합니다. 그러나 그정도 돈을 써서 만들어도 값어치를 못하기 때문이죠. 범용 모델은 모든 사람이 써야 학습비를 회수하는데, 주관을 넣는 순간 그 전제가 깨집니다. 만들어 봤자 그 성향인 사람만 쓰니까요. 제가 말하는 비용은 이겁니다.
여기서 반론이 있을 수 있ㅅ브니다. "주관은 이미 학습 데이터에 널려 있잖아. DHH 글도, 넷플릭스 테크블로그도 다 공개돼 있는데. 그냥 'DHH처럼 판단해'라고 하면 되는 거 아냐?"
맞습니다. 공개된 주관은 흉내가 납니다. "모놀리스 신봉자 관점에서 리뷰해 줘"라고 하면 그럴듯하게 나옵니다. 그런데 그건 DHH의 기준이지 우리 회사 기준이 아닙니다.
우리 회사의 기준은 테크블로그에 없습니다. 회의록 어딘가에, PR 리뷰 코멘트에, 고객 데이터에, "그건 우리가 안 하잖아"라는 한마디에 흩어져 있습니다. 왜 이 라이브러리를 안 쓰는지, 왜 이 팀은 테스트를 이 수준까지만 쓰는지, 왜 이 API는 일부러 느리게 만들었는지. 시니어가 PR을 보고 "뭔가 이상한데"라고 느끼는 그 순간은 어디에도 기록되지 않습니다. LLM에 학습할 정도를 모으기엔 부족하고, 모은다 해도 우리 회사만 씁니다. 재료가 없고, 팔 데가 없습니다. 그래서 안 넣습니다.
그럼 모델은 뭘 주냐면, 평균을 줍니다. 써 보면 압니다. 뭘 시키든 파이썬이고, 뭘 시키든 리액트입니다. 성능이 중요한 과제를 줘도 러스트를 먼저 꺼내는 일은 거의 없어요. 정렬 단계에서 평가자들은 익숙한 답을 고르고, 그러니 모델도 익숙한 답 쪽으로 갑니다. 맞는 걸 꺼내는 게 아니라 제일 많이 쓰는 걸 꺼냅니다. 평균에서 벗어난 우리 입장은 누군가 적어 줘야 합니다. 그리고 상품이 되는 건 이 비공개 기준입니다. 공개된 걸 흉내 내는 건 누구나 하니까요.
이미 다들 하고 계실 겁니다. CLAUDE.md, .cursorrules, AGENTS.md, 스킬, 전용 에이전트. 이름은 다른데 하는 일은 하나입니다. 모델 바깥에 우리 기준을 적는 겁니다.
제가 이 글을 쓰면서 가장 재밌었던 발견이 여기 있습니다. Claude Code 공식 문서가 CLAUDE.md에 뭘 넣으라고 하는지 보세요.
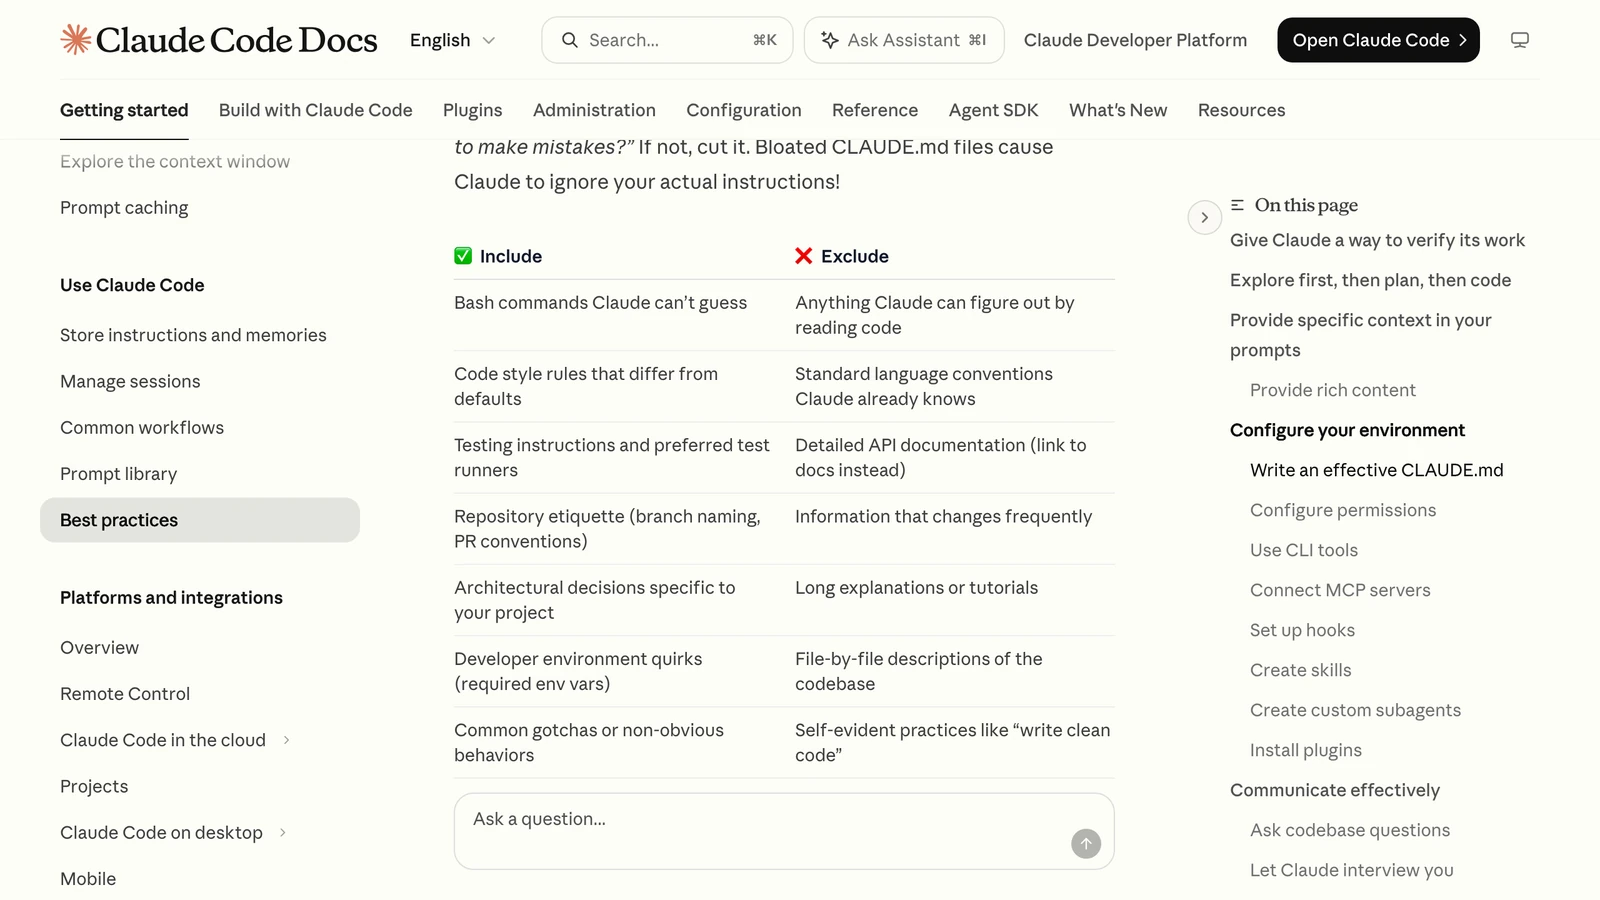 Claude Code 문서의 CLAUDE.md 안내. 넣을 것과 뺄 것
넣으라는 것: "기본값과 다른 코드 스타일 규칙", "우리 프로젝트에만 해당하는 아키텍처 결정". 빼라는 것: "Claude가 이미 아는 표준 언어 관례". 공식 문서가 그대로 말해 줍니다. 평균은 모델이 알고 있으니 적지 말고, 평균과 다른 우리 입장만 적으라고요.
저도 블로그 글을 쓰는 보관함에 문체 규칙과 금지어를 적은 파일을 두고 있는데, 그게 정확히 이겁니다. 모델은 평균적인 한국어를 알고, 제가 싫어하는 말투는 제가 적어 줘야 압니다. 기준이 바뀌면 파일 한 줄 고치면 끝납니다. 가중치는 못 고칩니다.
            범용 모델 (가중치)                 우리 기준 (파일)
     ┌──────────────────────────┐      ┌──────────────────────────┐
     │ 모든 사람이 쓰는 평균      │      │ 기본값과 다른 것만         │
     │ · 표준 관례               │      │ · 우리만의 아키텍처 결정    │
     │ · 인기 있는 스택          │  +   │ · 안 쓰는 라이브러리와 이유 │
     │ · 다툼 있는 판단엔 침묵    │      │ · 어디까지 테스트하는지    │
     │ · 고치려면 재학습          │      │ · 한 줄 고치면 끝          │
     └──────────────────────────┘      └──────────────────────────┘
                 ↓                                  ↓
          누구나 같은 결과                   우리 회사만의 결과
평균은 모델이, 입장은 파일이
기준을 적어 넣은 LLM은 범용 LLM과 다른 물건입니다. 그래서 팔립니다. 두 가지 모양으로요.
하나는 버티컬 SaaS입니다. 법률 쪽 Harvey는 1년 만에 매출이 네 배가 됐고, 같은 법률 영역에서 Legora, EvenUp이 같이 뜁니다. 이 회사들이 파는 건 모델이 아닙니다. 변호사의 기준을 모델 위에 얹은 겁니다.
 Harvey의 2026년 9월 투자 유치 보도
다른 하나는 FDE(Forward Deployed Engineer)입니다. 팔란티어가 만든 직군인데, 고객사에 직접 들어가서 그 회사의 워크플로와 판단 기준을 시스템에 옮겨 적는 사람입니다.
더 재밌는 건 범용 모델을 파는 회사들이 직접 이 일에 뛰어들었다는 겁니다. 올해 5월에 OpenAI는 수조 원을 받아서 FDE 회사를 따로 세웠고, 같은 달 Anthropic은 블랙스톤, 골드만삭스와 지역 은행·병원을 대상으로 하는 서비스 회사를 만들었습니다.
 Anthropic의 엔터프라이즈 서비스 회사 설립 발표
범용 모델을 가장 잘 아는 회사들이 "모델만으론 안 된다"고 회사를 차려서 보여 준 셈입니다. 모델을 팔아서 끝나면 사람을 고객사에 보낼 이유가 없으니까요.
그래서 저는 "AI가 전문가를 대체하냐"는 질문에 "네"라고 답합니다. 사람들은 점점 더 큰 결정을 기계에 맡길 겁니다. 다만 누가 대체하냐가 다릅니다.
OpenAI나 Anthropic의 모델 하나가 변호사를 대신하는 게 아닙니다. 범용 모델은 평균이라서 전문가 일을 못 가져갑니다. 그 위에 각자 다른 기준을 얹은 도구가 수백, 수천 개 나오고, 그 도구들이 서로 경쟁하면서 전문가 일을 나눠 맡습니다. 법률만 봐도 Harvey, Legora, EvenUp이 한 자리를 두고 싸우고 있잖아요. 셋이 담은 변호사의 기준이 서로 다르고, 그래서 셋 다 살아 있습니다.
그러니 "AI가 변호사를 대체하냐"는 질문은 틀린 질문인 것 같습니다. "어느 회사의 변호사 도구가 이기냐"가 맞는 질문입니다. 개발도 똑같습니다. "AI가 시니어를 대체하냐"보다 "어느 회사가 시니어의 기준을 가장 잘 담은 도구를 만드냐"입니다. 그런 도구는 앞으로 아주 많이 나올 거고, 범용 LLM 하나로는 거기까지 못 가고, 그중 어느 회사의 도구를 쓰느냐로 결과가 달라질 겁니다.
그러면 사람도 둘로 나뉩니다. 기준이 있어서 그걸 도구에 담고 그 경쟁에 참가자로 들어가는 쪽. 기준이 없어서 남이 담아 둔 도구를 사서 쓰는 소비자로 남는 쪽.
구현은 평균이 됐습니다. 코드를 치는 일, 흔한 패턴을 조립하는 일은 모델이 누구에게나 똑같이 줍니다. 다음 몇 년은 그 평균 위에 각자의 기준을 얹은 도구들이 경쟁하는 시기일 겁니다. 법률에서 이미 시작됐고, 의료와 고객 상담이 뒤따르고, 개발 쪽은 룰 파일과 스킬로 이미 시작했습니다. 모델 하나가 다 가져가지 않고, 기준을 담은 도구 천 개가 일을 나눠 맡습니다.
그러면 개발자의 일도 바뀝니다. 예전에는 "구현할 수 있냐"가 역량이었는데, 이제 그건 모델이 합니다. 시니어는 이제 코드 대신 룰 파일을 리뷰하고, ADR 대신 스킬을 씁니다. 어떻게 보면 늘 하던 일인데, 이제 그게 역량의 거의 전부입니다. 그래서 저는 요즘 세 가지에 집중합니다.
첫째, 의견을 갖는 연습입니다. 모놀리스냐 쪼개냐, 이 라이브러리를 쓰냐 마냐 같은 질문에 "상황에 따라 다르죠"로 넘기지 않고 제 답을 말하고 이유를 적습니다. 틀려도 됩니다. 기준이 없는 것보다 틀린 기준이 낫습니다. 틀린 기준은 고칠 수 있지만, 없는 기준은 도구에 넣을 수가 없으니까요.
둘째, 그 의견을 파일로 옮기고, 도구가 그대로 하는지 확인하는 일입니다. 제 보관함의 규칙 파일을 쭉 읽어 봤더니 문체 규칙은 꽤 적혀 있는데 기술 결정은 거의 없더라고요. 적어 놓고 끝이 아니라, 모델이 그 기준대로 움직이는지 보는 것까지가 한 세트입니다.
셋째, 비공개 기준이 쌓이는 곳에서 일하는 것입니다. 공개된 지식은 모델이 다 가져갑니다. 쓸모가 남는 건 어느 회사 안에만 있는 판단, 고객 데이터를 봐야만 알 수 있는 워크플로입니다. FDE든 버티컬 도구든, 그런 기준을 직접 볼 수 있어야 참가자가 됩니다.
경쟁이 무수히 많다는 건 들어갈 곳도 무수히 많다는 뜻이라, 저는 이쪽이 모델 하나가 다 가져가는 세상보다 오히려 열려 있다고 봅니다. 다만 거기 끼려면 자기 기준을 먼저 적어 놔야 하더라고요. 한 번쯤 CLAUDE.md든 AGENTS.md든 열어 놓고, 거기에 "기본값과 다른 우리 입장"이 몇 줄이나 있는지 세어 보면 어떨까요.
첫 댓글을 남겨보세요.